 MEIKAI
Come costruiamo e valutiamo gli agenti di ottimizzazione di Meikai
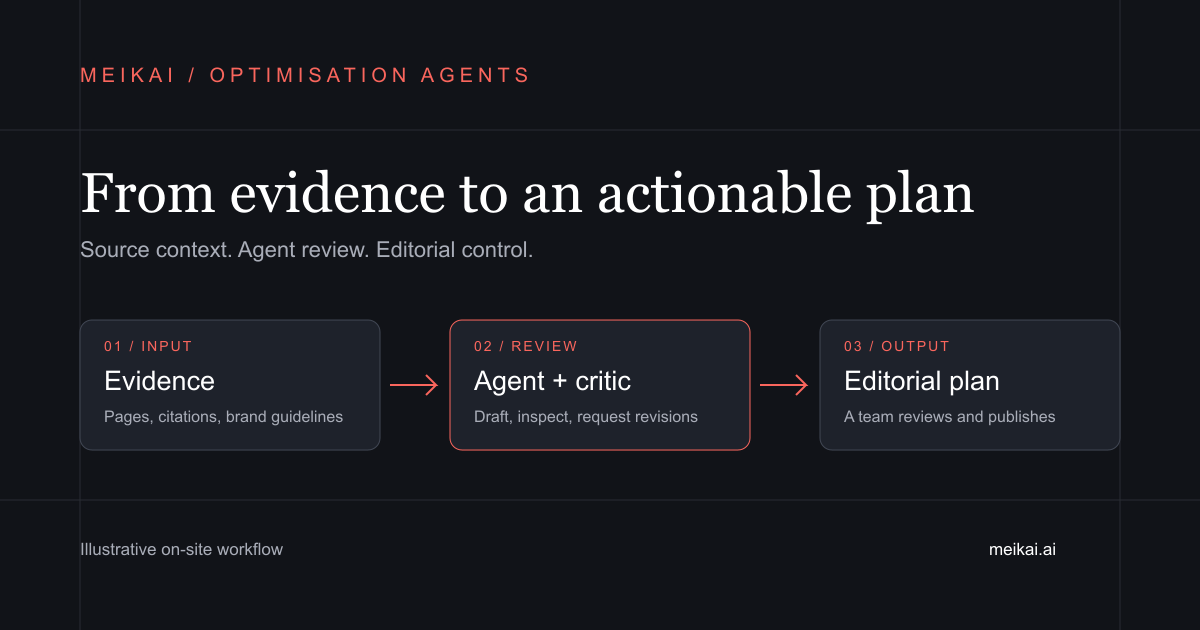
Meikai collega la misurazione della visibilità AI al lavoro di ottimizzazione. I suoi agenti usano risposte osservate, citazioni e linee guida del brand per preparare raccomandazioni che un team può rivedere e applicare. La questione utile è come queste evidenze diventano un piano specifico e come se ne verifica la qualità.
Gli agenti collegano le evidenze alle azioni
I workflow on-site esaminano il contenuto delle pagine e i prompt pertinenti, poi propongono modifiche legate a quel contesto. I workflow off-site preparano raccomandazioni per publisher e fonti rilevanti. Le linee guida del brand orientano tono, affermazioni consentite e scelte editoriali.
Un piano on-site può includere un punto di inserimento, un blocco di testo, elementi FAQ e metadati. Il contenuto dipende dalle evidenze e dal compito. Le raccomandazioni restano proposte: il cliente rivede e pubblica le modifiche nel proprio processo editoriale.
Come valutiamo: il LLM come giudice
La valutazione LLM-as-a-judge usa un modello per esaminare un output secondo una griglia scritta. Meikai usa queste valutazioni durante lo sviluppo e il workflow di generazione on-site include una fase critica che rivede la bozza e può richiedere correzioni. Sono controlli distinti; non costituiscono una soglia di punteggio universale per ogni raccomandazione in tutti i workflow.
Una revisione utile verifica se le affermazioni sono sostenute dalle evidenze fornite, se la modifica è abbastanza specifica da applicare e se rispetta le linee guida del brand. Un modello critico può non rilevare un errore: il suo verdetto non sostituisce la revisione editoriale e non dimostra un miglioramento delle risposte AI reali.
Migliorare gli agenti attraverso le valutazioni
I casi di valutazione permettono di confrontare configurazioni di prompt e modelli sugli stessi compiti. Gli errori aiutano ad aggiornare istruzioni, gestione delle evidenze e validazione degli output. Il modello critico on-site verifica il supporto fattuale, lo stile del brand e altri requisiti editoriali.
I punteggi misurano le prestazioni rispetto alla griglia scelta. L’impatto reale sulla visibilità richiede una misurazione separata dopo la modifica, con prompt comparabili e osservazioni ripetute. Un punteggio migliore non promette più citazioni.
Fondarsi sulla ricerca pubblicata
La ricerca GEO offre metodi e ipotesi da verificare. Non certifica l’implementazione di Meikai e non garantisce risultati per un determinato brand. Tre riferimenti utili:
- Metodi di ottimizzazione dei contenuti ed effetti che variano per dominio: GEO: Generative Engine Optimization (Aggarwal et al., KDD 2024).
- Un quadro per misurare l’influenza delle fonti: Beyond Keywords: Driving Generative Search Engine Optimization with Content-Centric Agents (Chen et al., 2025, preprint), che introduce CC-GSEO-Bench.
- Variabilità della misurazione: Don’t Measure Once: Measuring Visibility in AI Search, un tema esplorato anche nel nostro studio di ripetizione su 250.000 risposte.
Che cosa chiedere quando confronti le piattaforme
Chiedi di vedere le evidenze accessibili all’agente, un piano completo e il processo di revisione del workflow. Chiarisci quali controlli vengono eseguiti durante la generazione, quali nelle valutazioni di sviluppo e chi approva la pubblicazione.
Esplora il lavoro proposto nella pagina Ottimizzazione, costruisci l’insieme di misurazione in Prompt Studio, oppure parla con noi della tua categoria.
Domande frequenti
Che cosa significa che Meikai è una piattaforma agentica?
Gli agenti collegano le evidenze di misurazione ai compiti di ottimizzazione. Usano contenuti delle pagine, citazioni e linee guida del brand per preparare piani che il cliente rivede e applica.
Che cos’è la valutazione LLM-as-a-judge?
Un modello valuta un output secondo una griglia scritta. Meikai usa valutazioni durante lo sviluppo e una fase critica on-site che rivede le bozze e può richiedere correzioni. La copertura dipende dal workflow; un punteggio non garantisce accuratezza fattuale o guadagni di visibilità.
Come vengono migliorati gli agenti?
Il team confronta configurazioni su casi di valutazione e usa gli errori per affinare istruzioni, gestione delle evidenze e validazione. L’impatto reale sulla visibilità viene misurato separatamente dai punteggi.
Che cosa dovrebbe cercare un acquirente in un agente di ottimizzazione?
Chiedi le evidenze sottostanti, un piano concreto, i controlli del workflow e il processo di approvazione editoriale. Un piano utile identifica che cosa cambiare e offre al team il contesto per rivederlo.