 MEIKAI
Comment nous construisons et évaluons les agents d’optimisation de Meikai
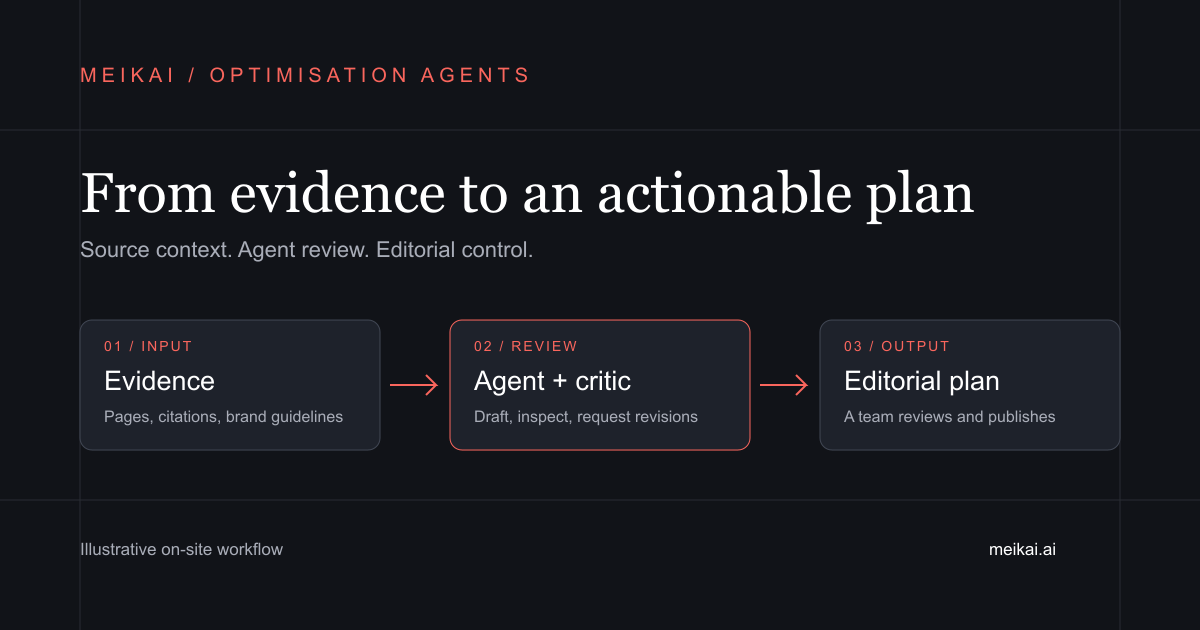
Meikai relie la mesure de visibilité IA au travail d’optimisation. Ses agents utilisent les réponses observées, les citations et les consignes de marque pour préparer des recommandations qu’une équipe peut revoir et mettre en œuvre. L’enjeu est de transformer ces éléments en un plan précis, puis d’en vérifier la qualité.
Les agents relient les preuves aux actions
Les workflows on-site examinent le contenu d’une page et les prompts auxquels elle répond, puis proposent des modifications liées à ce contexte. Les workflows off-site préparent des recommandations pour les éditeurs et les sources pertinents. Les consignes de marque encadrent le ton, les affirmations autorisées et les choix éditoriaux.
Un plan on-site peut comprendre un point d’insertion, un bloc rédigé, des éléments de FAQ et des métadonnées. Son contenu dépend des preuves et de la tâche. Les recommandations restent des propositions : le client revoit et publie les changements dans son propre circuit éditorial.
Notre méthode d’évaluation : le LLM comme juge
L’évaluation LLM-as-a-judge utilise un modèle pour apprécier une production selon une grille écrite. Meikai utilise ces évaluations pendant le développement, et son workflow de génération on-site comprend une étape critique qui relit le brouillon et peut demander des corrections. Ces contrôles sont distincts ; ils ne constituent pas un seuil de notation universel appliqué à chaque recommandation dans tous les workflows.
Une revue utile vérifie si les affirmations sont étayées par les éléments fournis, si le changement est assez précis pour être appliqué et s’il respecte les consignes de marque. Un modèle critique peut manquer une erreur : son verdict ne remplace donc pas la revue éditoriale et ne démontre pas une amélioration des réponses IA en conditions réelles.
Améliorer les agents grâce aux évaluations
Les cas d’évaluation permettent de comparer des configurations de prompts et de modèles sur les mêmes tâches. Les échecs aident à ajuster les instructions, le traitement des preuves et la validation des résultats. Le modèle critique on-site vérifie notamment l’appui factuel et le respect du style de marque.
Les scores mesurent la performance selon la grille retenue. L’impact réel sur la visibilité doit être mesuré séparément après un changement, avec des prompts comparables et des observations répétées. Un meilleur score ne promet pas davantage de citations.
S’appuyer sur la recherche publiée
La recherche GEO propose des méthodes et des hypothèses à tester. Elle ne certifie pas l’implémentation de Meikai et ne garantit pas les résultats d’une marque. Trois références utiles :
- Les méthodes d’optimisation du contenu et leurs effets selon le domaine : GEO: Generative Engine Optimization (Aggarwal et al., KDD 2024).
- Un cadre de mesure de l’influence des sources : Beyond Keywords : Driving Generative Search Engine Optimization with Content-Centric Agents (Chen et al., 2025, prépublication), qui présente CC-GSEO-Bench.
- La variabilité de la mesure : Don’t Measure Once : Measuring Visibility in AI Search, un sujet également exploré dans notre étude de répétition sur 250 000 réponses.
Les questions à poser pour comparer les plateformes
Demandez à voir les preuves accessibles à l’agent, un plan complet et le processus de revue du workflow concerné. Distinguez les contrôles effectués pendant la génération, ceux des évaluations de développement et la responsabilité de l’approbation avant publication.
Découvrez les travaux proposés sur la page Optimisation, construisez votre jeu de mesure dans Prompt Studio, ou échangez avec nous sur votre catégorie.
Questions fréquentes
Que signifie le fait que Meikai soit une plateforme agentique ?
Les agents relient les données de mesure aux tâches d’optimisation. Ils utilisent le contenu des pages, les citations et les consignes de marque pour préparer des plans que le client revoit et met en œuvre.
Qu’est-ce que l’évaluation LLM-as-a-judge ?
Un modèle évalue une production selon une grille écrite. Meikai utilise des évaluations pendant le développement et une étape critique on-site qui relit les brouillons et peut demander des corrections. La couverture dépend du workflow ; un score ne garantit ni l’exactitude des faits ni un gain de visibilité.
Comment les agents sont-ils améliorés ?
L’équipe compare des configurations sur des cas d’évaluation et utilise les échecs pour affiner les instructions, le traitement des preuves et la validation. L’impact réel sur la visibilité est mesuré séparément des scores d’évaluation.
Que doit rechercher un acheteur dans un agent d’optimisation ?
Demandez les preuves sous-jacentes, un plan concret, les contrôles appliqués au workflow et le processus d’approbation éditoriale. Un plan utile précise quoi changer et donne à l’équipe le contexte nécessaire à sa revue.